더보기
AI Computer Vision 과목을 배우는 동안 정신이 없어, 공부한 걸 정리할 엄두를 못 냈다. 과목이 끝났으니 시간을 내서 하나씩 정리해보려고 한다.
0. Deep Learning
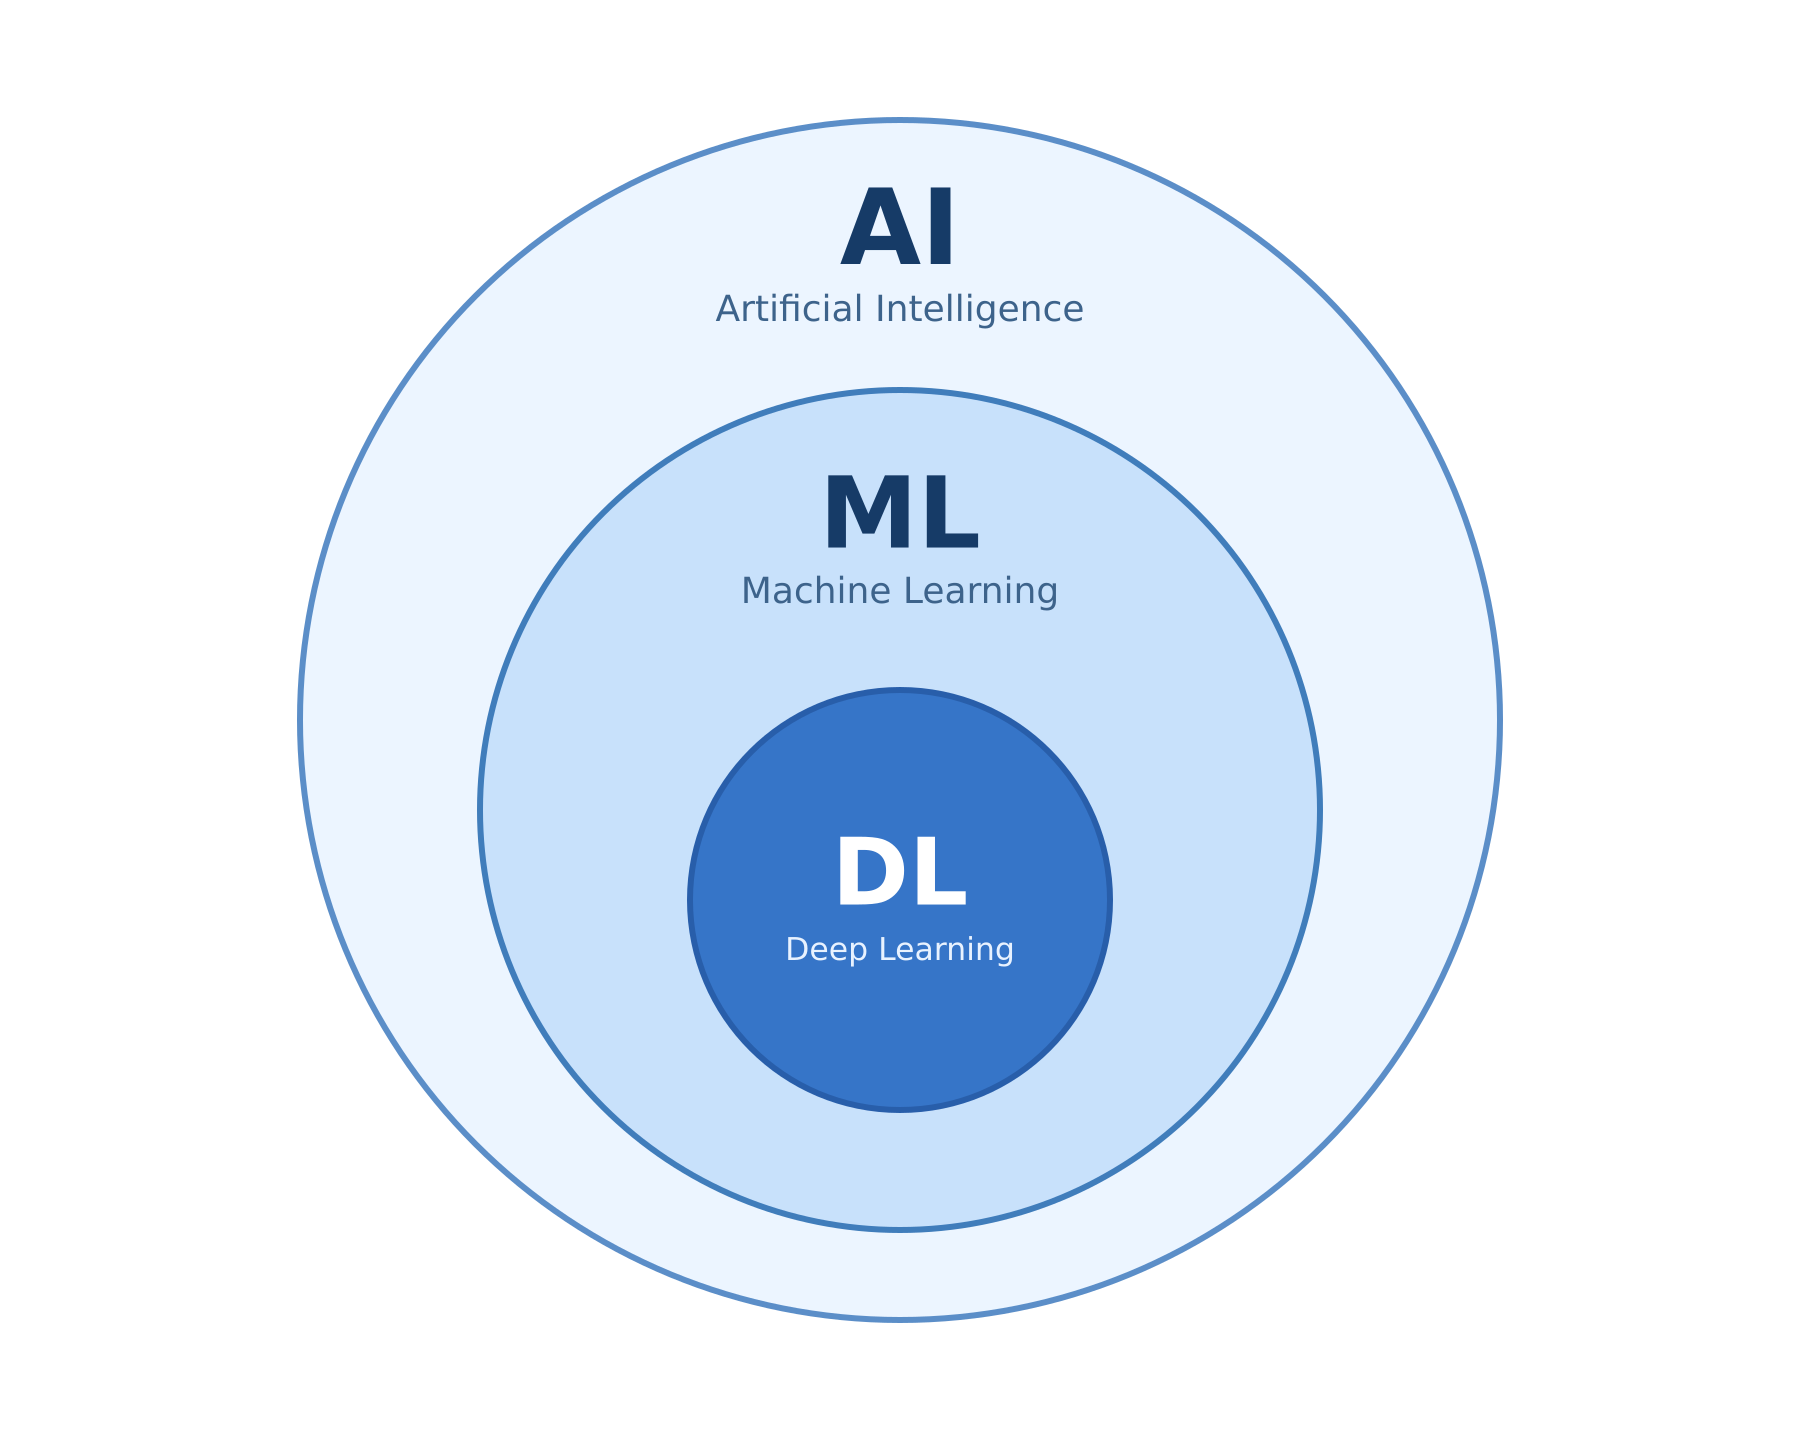
- AI(Artificial Intelligence, 인공지능) : 사람처럼 생각하는 모든 기술
- ex : 체스를 두는 AI, 자동 번역기, 챗봇 등
- ML(Machine Learning, 기계학습) : 데이터로부터 스스로 학습하는 AI
- ex : 스팸 메일 필터, 고객 분류 AI
- DL(Deep Learning, 딥러닝) : 인간의 뇌처럼 여러 층으로 학습하는 ML
- 인간의 신경망을 모사하여, 여러 층으로 쌓은 레이어를 통과해 결과를 예측/분류함
- 사실상, 활성 함수, 배치 정규와, Drop Out등의 기법을 중간에 섞은, 텐서 곱이다.
- ex : MLP (Multilayer Perceptron)
더보기
어떤 의미에선, 믿음의 영역같이 느껴지기도 한다. '모든 데이터는 특정한 다차원 공간에서 영역으로 표현할 수 있다.'는 직관을 받아들이면, 무엇이 되었든 그러한 데이터들을 잘 분류할 수 있게 데이터를 모으고 모델의 레이어를 쌓으면 결과를 예측, 분류하는 AI가 어떻게 행렬(텐서)들과 1차 연산만으로 만들어질 수 있는지 이해할 수 있게 된다. 물론, 수학자들과 통계학자, 물리학자들이 그 직관 이상의 논리를 통해, 단순한 MLP의 한계를 극복하고 더 뛰어난 AI를 만들기 위한 각종 기법(당장 활성화 함수 ReLU의 사용으로 MLP를 만든 것부터 그렇다)들을 고안해왔고, 지금도 연구 각종 연구 결과가 쏟아지고 있다.
1. PyTorch
- Python으로 딥러닝 모델을 만들고 학습시키는 데 사용하는 라이브러리
- 이전에 TensorFlow로 딥러닝을 했으나 2017년 PyTorch가 등장한 이후 Python과 PyTorch의 편의성과 직관성, 연구 코드가 쌓이게 되면서 딥러닝의 주류가 됨
1 - 1. Tensor
- 벡터 공간 및 그 쌍대 공간들을 일종의 '곱연산'을 사용해 복합적으로 연결시킨 구조
- 수학적 엄밀함보단 딥러닝에서 사용을 기준으로 나누면 아래와 같다.
- 텐서 자체는 numpy로도 만들 수 있지만, 계산 그래프를 연결하고 딥러닝의 주요 연산(Forward Propagation, Back Propagation, Optimizer.step() 등)을 수행하려면 torch.Tensor로 변환해야 한다.
| 차원 수 | 형태 | .shape | 예 | |
| 0 | 스칼라 (Scalar) | [a] | (1, ) | np.zeros(1) |
| 1 | 벡터 (Vector) | [a b c d] | (n, ) | np.zeros(5) |
| 2 | 행렬 (Array) | [[a b c d], [e f g h], [ ... ]] |
(n, m) | np.zeros((4, 3)) |
| 3 이상 | 텐서 (Tensor) | [[[a b c d], [e f g h], [ ... ]], [[ ... ], ... [ ... ]]] |
(n, m, l, ...) | torch.Tensor(np.zeros((4, 3, 5))) |
1 - 2. Dataset / DataLoader
- PyTorch에서 데이터(예 : 라벨(정답)-이미지)를 담는 컨테이너 클래스
- torch.utils.data의 Dataset 클래스, DataLoader 클래스를 사용
- Dataset : 데이터 하나를 반환하는 방법
- DataLoader : 데이터를 배치 단위로 묶어 모델에 전달하는 방법, 배치 사이즈 조절, 훈련 데이터 Shuffle, 메모리 pinning 등의 기능을 지원
- 사용법을 요약하면, 데이터들을 처음부터 Dataset 타입으로 로드하거나 Dataset으로 변환
=> Dataset에 적용할 Transforms를 정의 (예 : 텐서 변환, 정규화, 각종 데이터 증강)
=> DataLoader에 Dataset를 탑재
=> 모델을 학습시키거나 모델을 사용해 예측을 할 때 data, labels in dataLoader와 같은 튜플 언패킹 방식으로 받아 모델에 전달 -
# 훈련용 Transform 정의
train_transform = transforms.Compose([
    transforms.RandomHorizontalFlip(p=0.5),
    transforms.Resize(224),
    transforms.CenterCrop(224),
    transforms.ToTensor(),
    transforms.Normalize(0.5, 0.5),
    transforms.RandomErasing(p=0.5, scale=(0.02, 0.33), ratio=(0.3, 3.3), value=0, inplace=False)
])

# 검증용 Transform 정의
test_transform = transforms.Compose([
    transforms.Resize(224),
    transforms.CenterCrop(224),
    transforms.ToTensor(),
    transforms.Normalize(0.5, 0.5)
])

# ImageFolder 라이브러리를 사용해 train_dir, test_dir에 있는 데이터를 DataSets로 로드
train_data = datasets.ImageFolder(train_dir, transform=train_transform)
test_data = datasets.ImageFolder(test_dir, transform=test_transform)

# Datasets를 DataLoader에 탑재
# 훈련용 데이터만 shuffle => 매 반복마다 배치에 포함되는 데이터의 구성을 랜덤으로 바꿔줌
# => 모델이 데이터의 순서까지 외워 과적합 하는 것을 방지함
train_loader = DataLoader(train_data, batch_size=32, shuffle=True)
test_loader = DataLoader(test_data, batch_size=64, shuffle=False)
- 사용법을 요약하면, 데이터들을 처음부터 Dataset 타입으로 로드하거나 Dataset으로 변환
- 각종 라이브러리, git 저장소 등에서 데이터를 다운받아 사용 가능
-
# 학습용 이미지 다운로드
w = !wget https://github.com/makaishi2/pythonlibs/raw/main/images/dog_wolf.zip
# !wget: colab 환경에서 리눅스의 wget 명령어를 실행하여 파일 다운로드

# 학습용 이미지 압축풀기
w = !unzip dog_wolf.zip
# 디렉토리명 설정
data_dir = 'dog_wolf'

# 학습, 테스트 디렉토리명 설정
import os
train_dir = os.path.join(data_dir, 'train')
test_dir = os.path.join(data_dir, 'test')

# 분류 클래스 설정
classes = ['dog', 'wolf']

# 훈련용 데이터 트랜스폼
train_transform = transforms.Compose([
    transforms.RandomHorizontalFlip(p=0.5),
    transforms.Resize(224),
    transforms.CenterCrop(224),
    transforms.ToTensor(),
    transforms.Normalize(0.5, 0.5),
    transforms.RandomErasing(p=0.5, scale=(0.02, 0.33), ratio=(0.3, 3.3), value=0, inplace=False)
])

# 테스트용 데이터 트랜스폼 (증강 X)
test_transform = transforms.Compose([
    transforms.Resize(224),
    transforms.CenterCrop(224),
    transforms.ToTensor(),
    transforms.Normalize(0.5, 0.5)
])

train_data = datasets.ImageFolder(train_dir, transform=train_transform)
test_data = datasets.ImageFolder(test_dir, transform=test_transform)

train_loader = DataLoader(train_data, batch_size=32, shuffle=True)
test_loader = DataLoader(test_data, batch_size=64, shuffle=False)
-
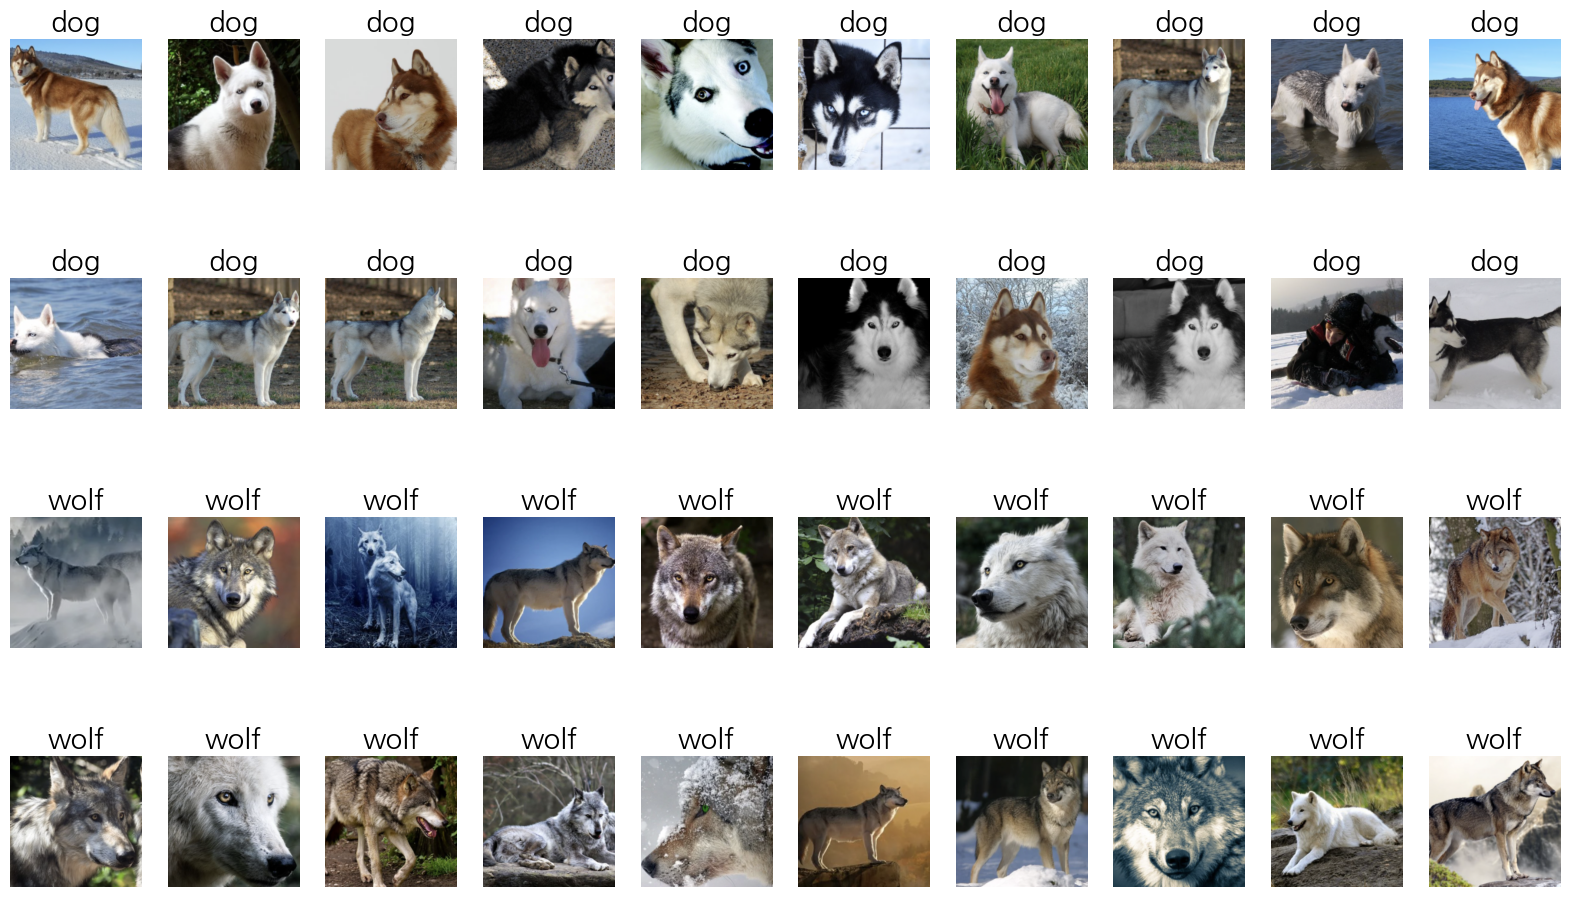
- 참고 : 사용된 개/늑대 데이터 셋
1 - 3. 모델 정의
- 파라미터(Weight + Bias)를 학습시킬 모델 정의
- torchvision의 models에서 이미 만들어진 모델을 다운받아 사용 가능
from torchvision import models
net = models.vgg19_bn(pretrained = True) # pretrained : 사전에 학습된 파라미터 적용